
ביום שלישי, 27.10, בעשר בלילה, מדגמי היציאה בערוצים המרכזיים נתנו לגוש נתניהו 50 מנדטים ולגוש השינוי 52–53. הספירה (כמעט סופית) הראתה 53 מול 48.
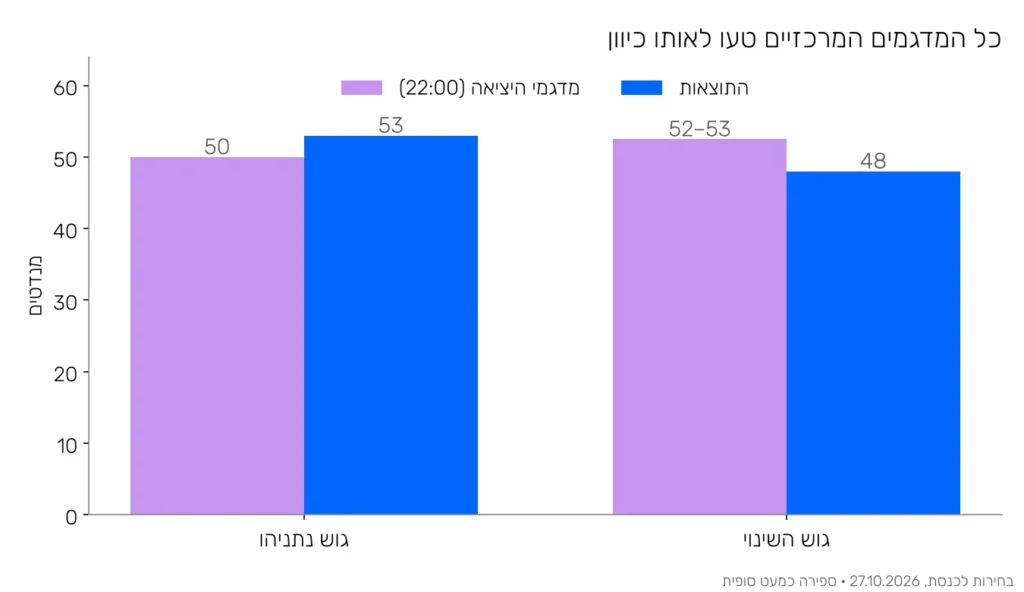
טעות של 3–5 מנדטים לגוש היא לא דרמה סטטיסטית בפני עצמה. מדגם יציאה דוגם כמה עשרות קלפיות מתוך כ-12 אלף. בתוך כל קלפי אנשים מצביעים די דומה (שכונה, קיבוץ, יישוב). לכן גם 12 אלף מרואיינים "שווים" בפועל הרבה פחות.
מה שכן מעניין הוא שכולם טעו לאותו כיוון (לא בדיוק כולם: 11, 12 ו-13 טעו לאותו הכיוון, ו-14 טעה לכיוון ההפוך). רעש מקרי מפזר טעויות לכל הכיוונים. כשכמה מדגמים זזים יחד, מחפשים משהו בשיטה, לא במזל.
ארבעה חשודים
1. שיעור ההצבעה. 77.7% הצביעו, השיעור הגבוה ביותר מאז 1999. המודלים משקללים לפי דפוסי ההצבעה בבחירות הקודמות. אם העלייה בהצבעה לא הייתה אחידה, וחזקה יותר באזורים שנוטים לצד אחד, המשקלות הישנים פשוט מפספסים אותה. כל ראיון יכול להיות מדויק, והתוצאה עדיין תטעה.
2. מי מסכים לענות לסוקר. מספיק שתומכי צד אחד מסרבים קצת יותר, למשל 55% מסכימים לעומת 61% בצד השני, כדי להזיז את התוצאה בכ-3 מנדטים. (ערוץ 14, כאמור, טעה בכיוון ההפוך: 60 מול 43. זה מתאים לרעיון שהנכונות לענות תלויה באמון בערוץ ששולח את הסוקר.)
3. אילו קלפיות נבחרו. אם יש סוג קלפיות שקשה לסקור בהן, ומחליפים אותן בקלפיות "דומות", ההטיה נכנסת לכל המדגם. ואם כל החברות מוותרות על אותן קלפיות, כולן יטעו יחד.
4. השעה האחרונה. הראיונות נגמרים לפני סגירת הקלפיות. אם קמפיין "גוועלד" מוציא מצביעים של צד אחד דווקא בשעות הערב, המדגם כבר סגור, ואת הגל הזה הוא לא רואה.
השיעור שחשוב גם מחוץ לבחירות
החשוד השני הוא החשוב ביותר עבור כל ארגון שמריץ סקר.
נניח שמגדילים את המדגם פי 20. הנה סימולציה של מה שקורה כשצד אחד נענה לסוקר בשיעור נמוך בעשירית מהאחרים:
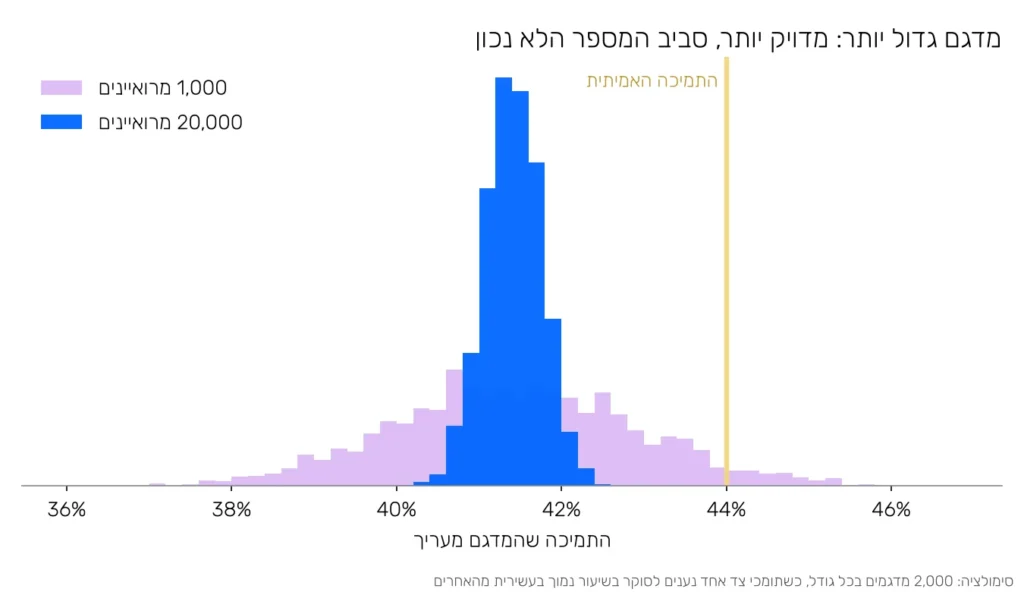
המדגם הגדול צר ומדויק בהרבה, אבל סביב המספר הלא נכון. כאן ההבדל בין שני סוגי טעויות:
- רעש קטֵן כשמגדילים את המדגם.
- הטיה לא קטנה כשמגדילים את המדגם. כדי לתקן אותה צריך להבין מי לא ענה, ולמה.
אותו מנגנון קיים בסקר שביעות רצון של עובדים, בסקר לקוחות ובמדידה בקרב תושבים. עובדים שחוקים עונים פחות. לקוחות מאוכזבים לפעמים עונים יותר. אחוז השבה גבוה לא מבטיח כלום אם מי שלא ענה שונה ממי שענה.
אז איך יודעים מי צדק?
לכל אחד מהחשודים יש "חתימה" בנתונים. ועדת הבחירות מפרסמת תוצאות לכל קלפי, ולכן אפשר להשוות כל קלפי שנדגמה לתוצאה האמיתית שלה. אם המדגם והקלפי מסכימים, הבעיה הייתה בבחירת הקלפיות. אם הם לא מסכימים, הבעיה הייתה בראיונות. זה לא לוקח מלא זמן, והנתונים ברובם כבר קיימים.
זה בדיוק סוג הבדיקה שאנחנו עושים במכון שריד לפני שאנחנו סומכים על תוצאה: לא רק "כמה ענו", אלא מי ענה, מי לא, ומה זה עושה למספר.
(הניתוח המלא, כולל הסימולציות והקוד, מופיע בהרצאה בקורס ניתוח נתונים סטטיסטי באוניברסיטת תל אביב.)